纵向可穿戴与行为基础模型
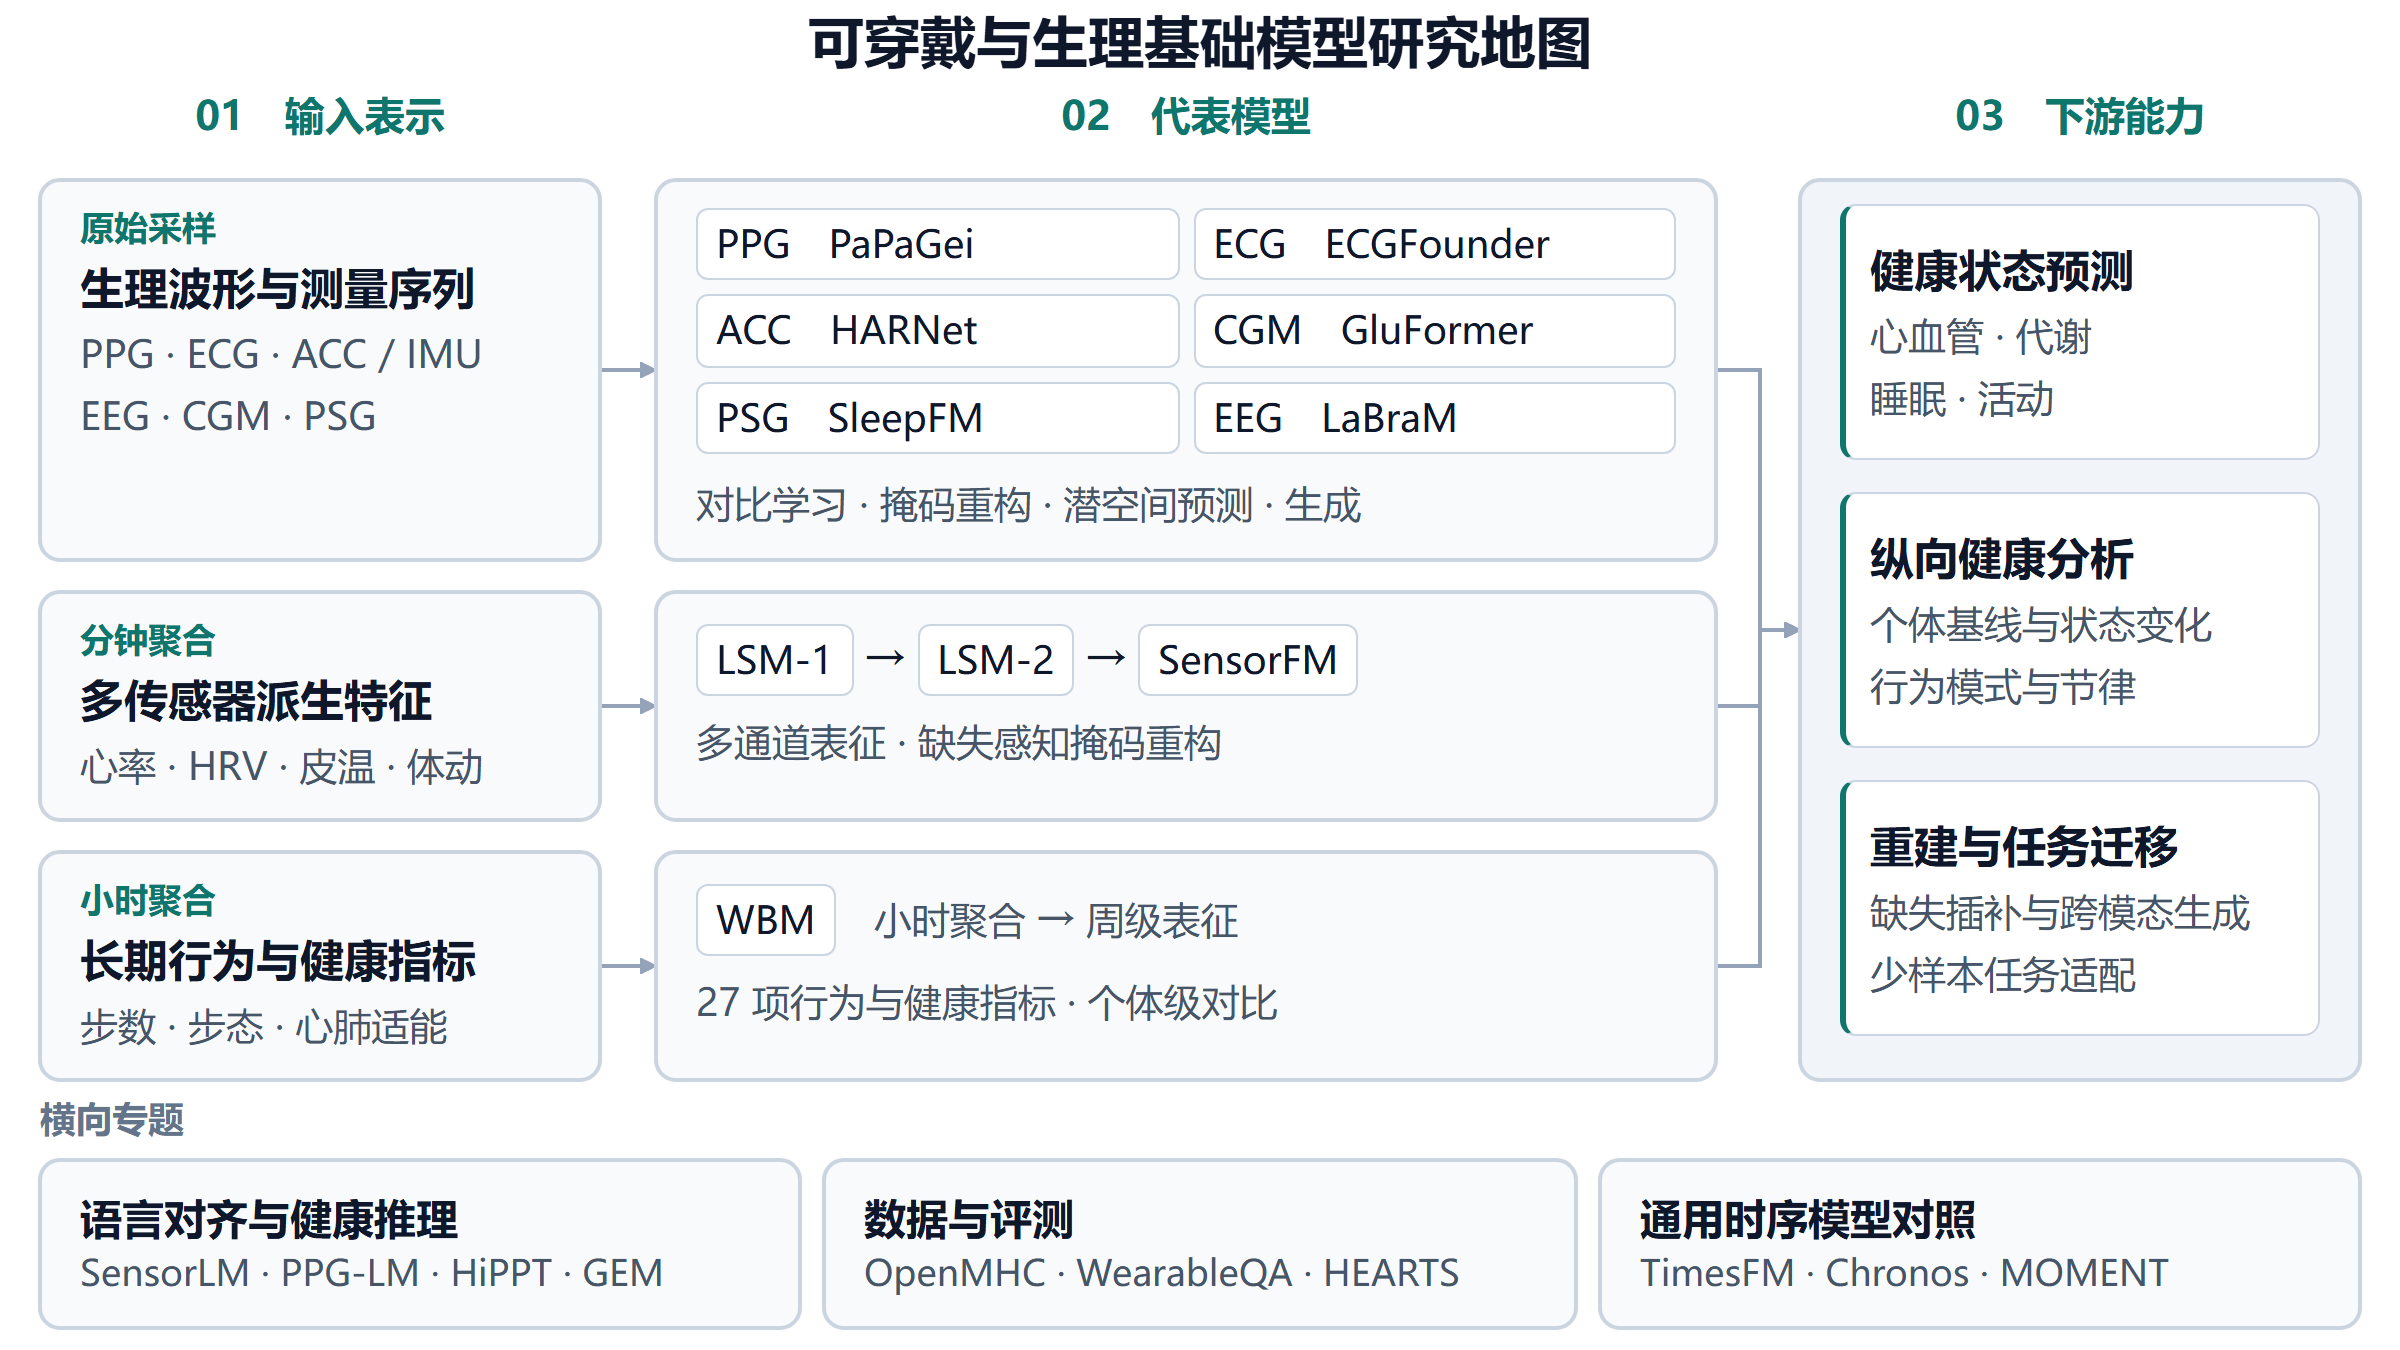
本专题按模型实际接收的数据粒度梳理 Google LSM-1、LSM-2、SensorFM、SensorWM、SensorLM、WavesFM 与 Apple WBM。分钟级派生特征、小时或周级生理与行为指标和原始生理波形具有不同的信息量、缺失机制与适用任务。选型时应同时比较输入定义、观察窗口、受试者划分和下游适配协议。
SensorWM 的资料与资源状态截至 2026-11-09,其余条目截至 2026-11-04。LSM 在后续 Google 工作中称为 LSM-1;独立团队的复现与原作者模型具有不同的训练数据和资源来源。
系列关系
Google LSM-1 建立分钟级多传感器特征的规模化预训练基线,LSM-2 将真实缺失纳入训练与推理,SensorFM 延续 AIM 并扩大人群规模和健康任务范围。Apple WBM 则研究小时聚合的行为与健康指标,在周级窗口上学习表征。WavesFM 以分阶段预训练连接短时 PPG / ACC 波形形态与周内时间关系,补充从原始信号出发的纵向建模路线。这五项工作分别说明规模、缺失处理、健康任务迁移、长期行为指标和波形层级建模的不同选择。
SensorWM 研究给定行为序列后的周级生理轨迹预测,独立预训练状态编码器与动力学模型。SensorFM 在该论文中用作静态表征对照,并非 SensorWM 的编码器或初始化来源。
SensorLM 是传感器与语言对齐路线,可与上述数值表征模型对照。OpenMHC 提供独立数据上的 WBM、LSM 系列复现和评测入口。
横向对比
| 工作与发表 | 输入与窗口 | 架构与核心机制 | 训练规模 | 论文结果与评测设置 | 官方资源 |
|---|---|---|---|---|---|
| LSM-1 ICLR 2025 |
26 个分钟级派生特征 5 小时窗口 |
ViT MAE 二维分块与随机掩码重构 |
165,090 人 主要结果用 660 万小时,扩展实验最高 4,000 万小时 |
8 类活动识别,全量微调准确率 68.5%,监督训练基线 53.2% | 论文 原作者代码与权重未见公开链接 |
| LSM-2 arXiv 2025 |
26 个分钟级派生特征 24 小时窗口 |
ViT-1D,约 25M 参数 AIM 继承真实缺失并加入人工掩码 |
60,440 人 原文报告 4,000 万小时 |
高血压线性探测 AUROC 0.754,同设置重训 LSM-1 为 0.739 | 论文 原作者代码与权重未见公开链接 |
| SensorFM arXiv 2026 |
五类传感器派生的 34 个分钟级特征 24 小时窗口 |
ViT-1D MAE + AIM 约 0.139M-110.763M 参数 |
500 万人 论文分别报告超 20 亿多模态数据小时、超 1 万亿传感器分钟 |
35 项判别任务中 34 项优于工程特征监督基线 | 论文 原作者代码与权重未见公开链接 |
| SensorWM arXiv 2026 |
周级生理与行为派生指标 12 周训练窗口 |
MLP 编码器与行为条件二阶潜状态动力学 轨迹预测、位移约束与防坍塌正则 |
96,957 人、228 万人周 182,797 个有效 12 周窗口 |
给定实际未来行为时,静息心率预测 R² 0.877,LOCF 为 0.705;教练方案另作离线专家评价 | 论文 作者计划于发表时发布代码 |
| SensorLM NeurIPS 2025 |
26 个分钟级派生特征与分层描述 24 小时窗口 |
ViT + 文本编码器与解码器 对比对齐与描述生成 |
103,643 人 约 5,970 万小时 |
20 类活动零样本 AUROC 0.84、Macro-F1 0.29 | 论文 参考代码,未列原始权重 |
| WBM ICML 2025 |
27 个 HealthKit 指标及缺失标记 小时聚合、7 天窗口 |
TST 词元化 + Mamba-2 个体级对比学习 |
全部数据集为 161,855 人、1,514 万人周 按人划分 80% / 10% / 10% |
57 项任务,睡眠时长回归 R² 为 0.590,统计特征基线 0.104 | 论文 作者声明代码与权重无法发布 |
| WavesFM arXiv 2026 |
15 秒 PPG / ACC 波形 5 分钟表示、7 天窗口 |
EfficientNet-B7 + 6 层 Transformer 参与者对比预训练、双分支掩码重构;总参数量未报告 |
第一阶段约 32.4 万人、680 万小时 第二阶段约 1 万人、530 万小时 |
58 个个体级二分类任务,平均 AUROC 0.766;多周表示汇聚后线性探测 | 论文 该可穿戴模型的代码与权重获取方式尚不明确 |
表中结果来自各自论文的独立队列与协议,跨行指标仅用于说明研究覆盖面。LSM-2 表中的 LSM-1 对照是同设置重训版本,不能直接替代 LSM-1 原论文结果。WBM 的约 25 亿小时描述全部数据集,实际训练集按参与者划分,不能直接写成全部用于预训练。
数据规模保留原文统计边界。SensorFM 同时报告“超 20 亿多模态数据小时”和“超 1 万亿传感器分钟”;LSM-2 第 3 节同时出现 3,581,748 人天和 4,000 万小时,另以约 160 万日窗口讨论缺失分布。原文没有充分解释这些统计量的对应关系,因此作者报告的时长不能直接相互换算,也不适合据此排列厂商数据规模。SensorFM 数据定义 · LSM-2 第 3 节
LSM-1
Google Research / Google DeepMind / 华盛顿大学 · ICLR 2025 · 论文 · 会议记录

图源:LSM-1 论文 Fig. 1(arXiv:2410.13638v1)。
LSM-1 将心率、HRV、活动等分钟级特征组成时间与通道矩阵,通过掩码自编码学习可迁移表征。常规实验先补齐缺失值,使用 5 小时窗口,研究数据量、模型容量和计算量的变化。
主要结果采用约 660 万训练小时,4,000 万小时属于扩展实验。原论文 Table 3 的 8 类活动识别准确率由监督基线的 53.2% 提高到全量微调的 68.5%,线性探测为 49.4%。适配方式会明显改变结论,表征比较应同时保留冻结探测和微调协议。论文第 3-5 节及附录 B
评注
该工作适合作为分钟级特征预训练的历史基线。复现时需要保留插补策略和受试者均衡采样信息,避免将数据扩展带来的收益与预处理变化混在一起。
LSM-2
Google Research 及合作团队 · arXiv 2025 · 论文 · 官方介绍

图源:LSM-2 论文 Fig. 4(arXiv:2506.05321v1)。
AIM 将数据原有缺失与人工遮挡合并,通过固定数量词元移除和注意力掩码处理不同样本的缺失比例。重构损失仅作用于原本有观测值的人工遮挡区域,推理时继续使用真实缺失掩码。
输入为 26 × 1,440 的日级特征矩阵,以 10 分钟为单通道分块长度。作者在同设置比较中报告高血压 AUROC 由 0.739 提高至 0.754,焦虑 AUROC 由 0.743 提高至 0.758。20 类活动识别 AUROC 为 0.899,略低于 LSM-1 对照的 0.900,结果应按任务阅读。论文第 4-6 节
评注
该方法适合研究真实缺失的处理。自有数据应进一步区分脱表、硬件间歇采集与质量过滤,并评估这些缺失模式是否与设备或人群标签相关。
SensorFM
Google Research 及合作团队 · arXiv 2026 · 论文 · 官方介绍
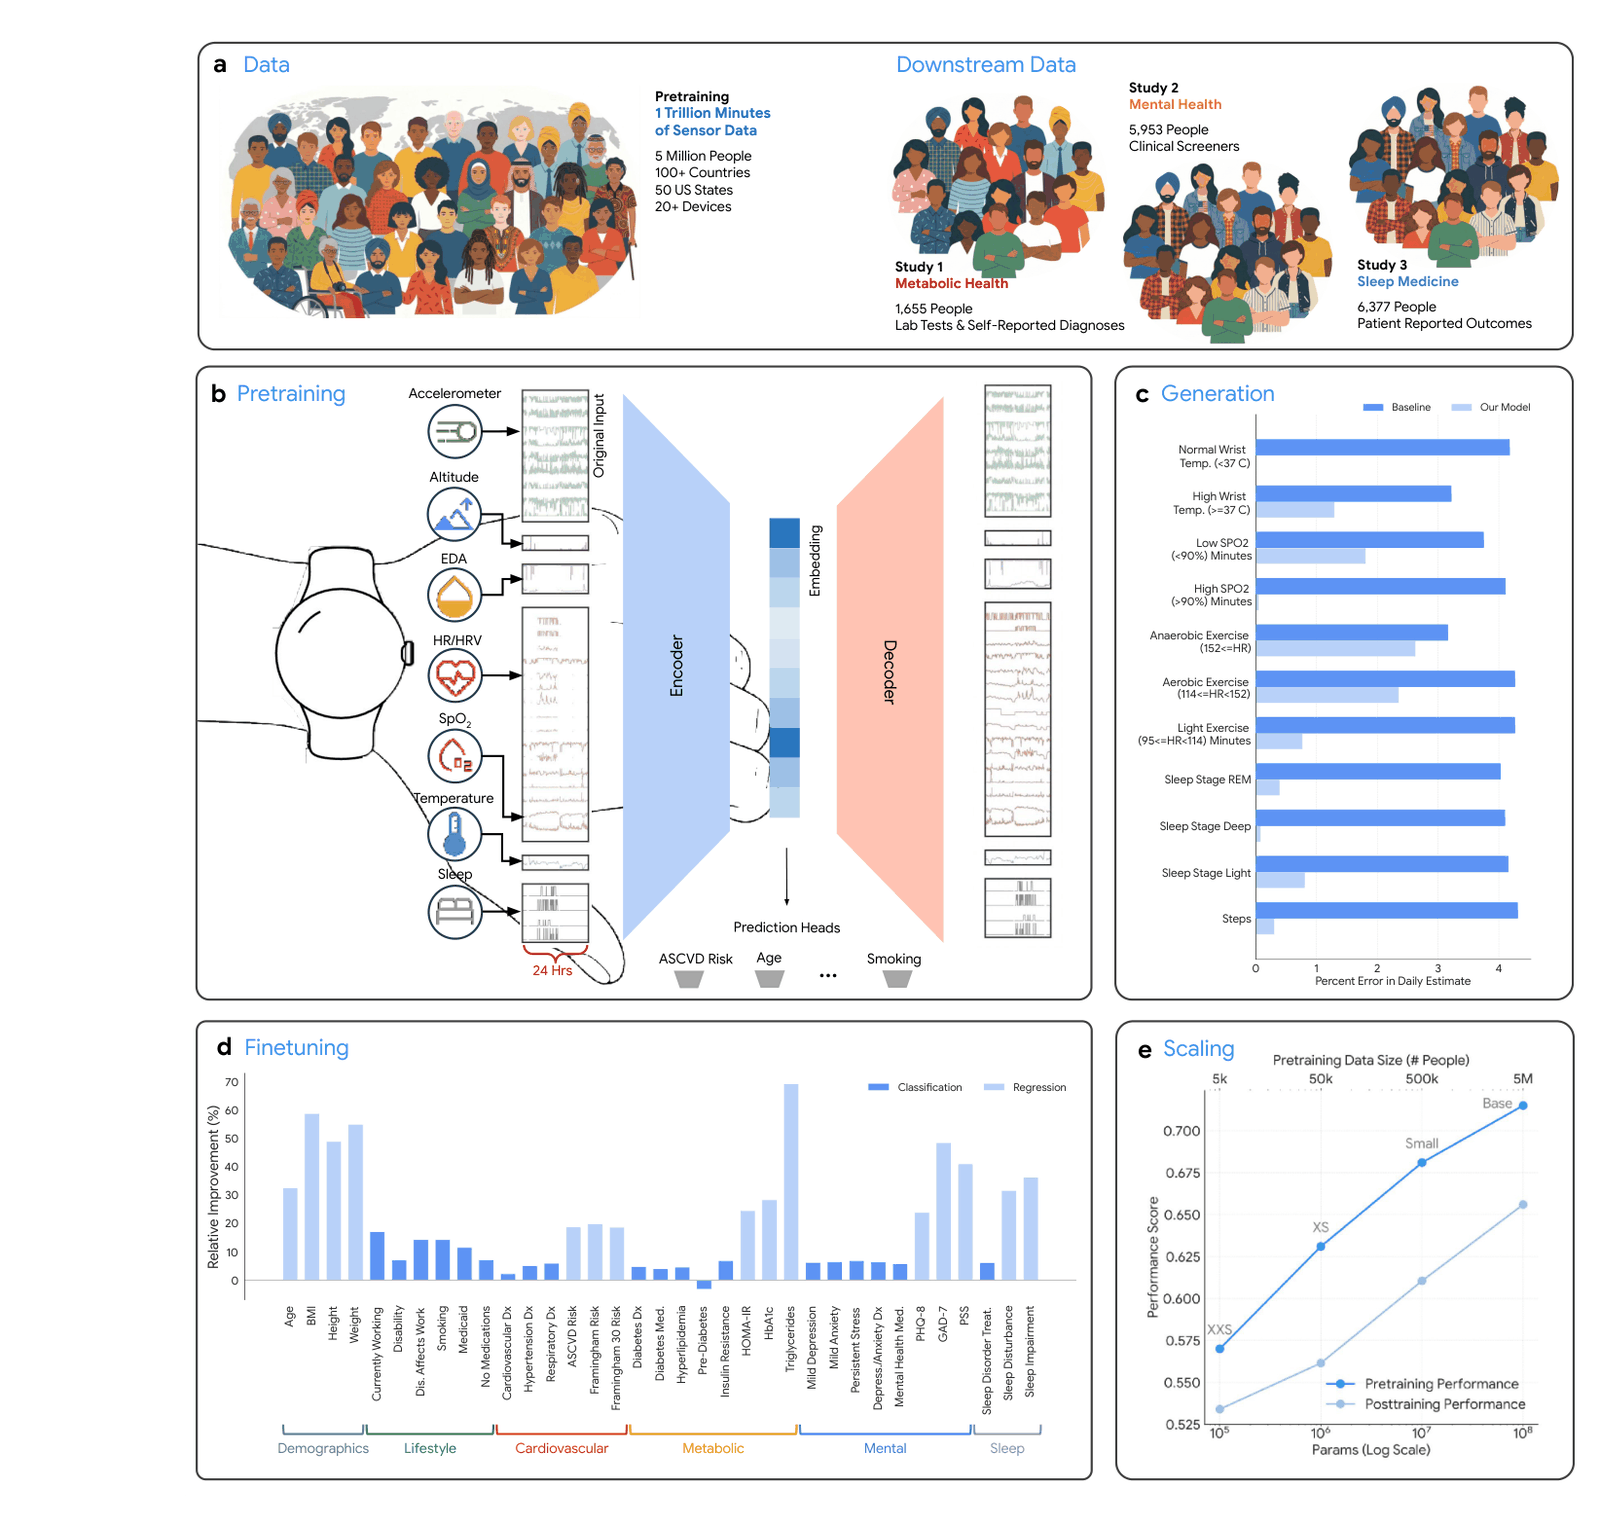
图源为 SensorFM 论文 Fig. 1,arXiv 2605.22759。
SensorFM 延续 LSM-2 的 AIM,在五类传感器派生的 34 个分钟级特征上学习日级表征。公开模型配置覆盖约 13.9 万至 1.108 亿参数,包含编码器与解码器。训练目标为可观测区域上的掩码重构。
论文评估 35 项健康、生活方式与人口统计任务。34/35 的比较对象是工程特征监督基线,33/35 则指最大的 SensorFM-B 在不同容量版本之间胜出的任务数。冻结表征还可供下游预测头和健康 Agent 使用,Agent 评估包含 1,860 次临床人员评分;该静态摘要实验与原 PHA 系统的关系见 PHA 应用案例。论文第 2 节及方法 M.3
判别评测的 35 项任务均为个体级标签。作者对同一个人全部可用天数中的有效词元表示计算均值与标准差,再降至 50 个主成分并训练任务头。因此,24 小时指编码器窗口,不代表最终预测只使用一天。预训练使用日长滑窗;时间编码还包含星期和年内日期。方法 M.3.1、M.3.2、M.3.4
评注
该工作的价值在群体级扩展和广泛任务迁移。研究输入依赖设备端已经计算的特征,迁移到其他硬件时应核对特征定义、校准与缺失规则。Agent 摘要评分与患者结局属于不同证据层次。
SensorWM
Google Research / 加利福尼亚大学洛杉矶分校 · arXiv 2026 · 论文
Sensor World Model(SensorWM)研究给定步数、睡眠和运动行为后,未来数周的生理指标怎样变化。论文 Personalized health coaching via coachable health age and counterfactual wearable trajectories 将它与可指导行为改变的健康年龄(Coachable Health Age,CHA)及语言模型教练组合。以下依据 2026-11-05 发布的 v1,资料截至 2026-11-09。
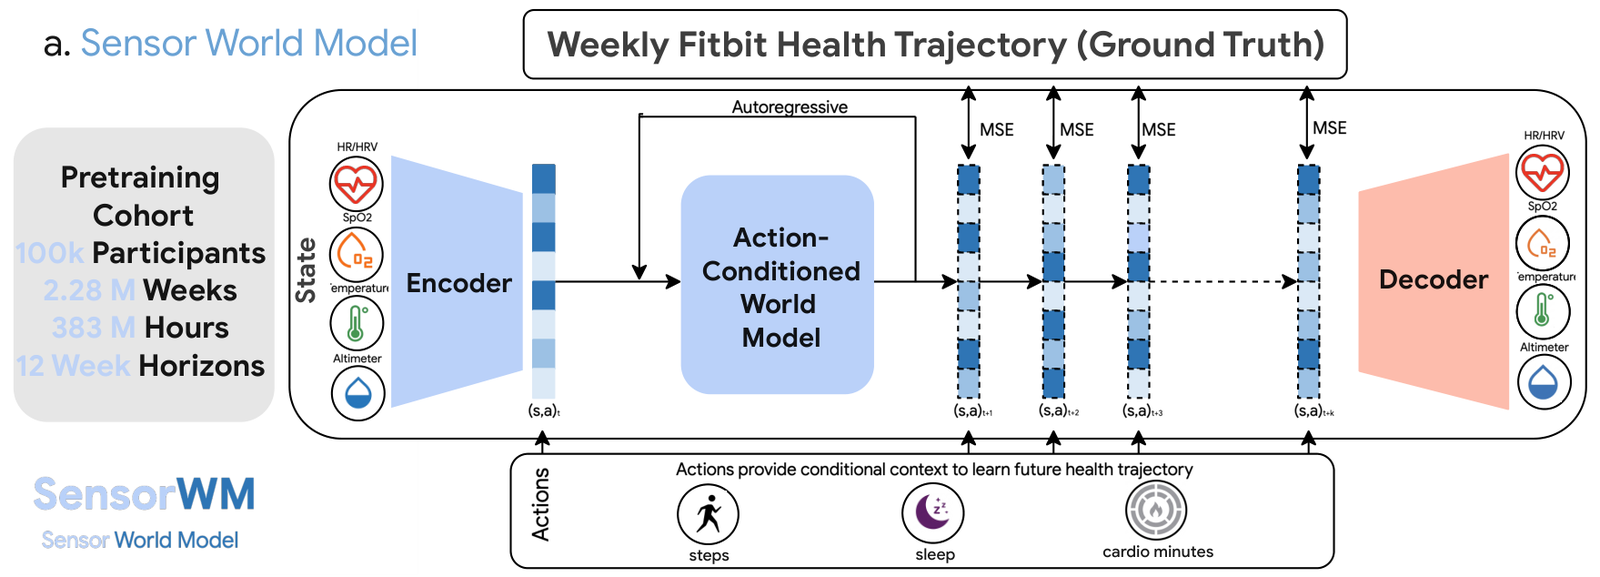
图源:SensorWM 论文 Fig. 3a(arXiv:2611.08568v1,第 9 页),裁取模型架构部分。
时间步与输入输出
模型使用 Fitbit 的周级聚合指标,不直接读取原始 PPG / ECG 波形。日级测量按一周内的有效观测日求均值,每个时间步对应一个周级向量。例如,下一周的静息心率预测是该周平均水平,深睡预测是该周平均每晚的深睡分钟数,输出不展开为七天各自的数值。其任务可以理解为多变量、单步状态预测,再递归生成多周轨迹。方法 §4.2.1–4.2.2
| 角色 | 具体字段或指标 | 在轨迹模拟中的作用 |
|---|---|---|
| 外部行为条件 | 步数、主睡眠时长、心肺运动强度区间时长(cardio-intensity minutes) | 每一步提供相应行为值;方案模拟时可替换为候选目标 |
| 生理状态 | 静息心率、心率变异性(HRV)、呼吸率、血氧、皮肤温度等 | 用真实历史初始化,后续通过动力学模型预测 |
| 睡眠与活动状态 | 深睡、浅睡、REM、睡眠期间清醒时长,以及心率区间时长、活动区间分钟数(Active Zone Minutes,AZM)等 | 描述睡眠结构和活动相关响应,与上述三个行为字段分开处理 |
| 静态背景 | 年龄、性别、BMI 等 | 提供个体背景,不作为可调行为目标 |
AZM 是 Fitbit 按心率强度加权的活动时长:中等强度区间每分钟计 1 AZM,较高强度或峰值区间每分钟计 2 AZM。例如,20 分钟中等强度加 10 分钟高强度活动计 40 AZM。它与 cardio 分钟数有关联,但不是同一字段;论文将前者归入状态、后者归入动作。Fitbit 官方说明 · 方法 §4.3.1
每次转移同时依赖最近两个潜状态和行为条件,不能仅用步数、睡眠等行为确定下一周的指标。最初两周取真实观测,之后沿预测的潜状态继续递归;后续行为仍由外部逐步提供。预测评测使用参与者实际记录的后续行为,教练模拟使用候选行为目标,未将用户是否执行目标作为单独预测任务。方法 §4.2.3–4.2.7
上述划分描述的是动作与状态在模拟中的角色。附表 11–12 也报告了 step_cnt 和 total_sleep_duration 的预测成绩;其中总睡眠字段与动作 sleep_main_asleep_minute_cnt 的名称不同。正文未充分说明这些输出列与动作输入的字段对应、时点关系及 CHA 取值方式,因此不能据此认定模型会用预测行为替代候选目标,也不能将其成绩解释为未知未来行为下的自由预测。方法 §4.2.2、附表 6、11–12
结构与预训练
预训练覆盖 96,957 人、228 万人周、182,797 个有效 12 周窗口,参与者序列最多 24 周。训练窗口内先用两个真实状态初始化,再预测其余状态;12 周窗口长度与教练应用中的未来 12 周模拟跨度需分别理解。方法 §4.2.1、§4.2.4
状态编码器是隐藏维度 256、输出 128 维的多层感知机(MLP),与行为条件预测器联合预训练;SensorFM 仅为对照,不提供初始化权重。预测器通过自适应层归一化和乘法行为门控接收行为 a,生成 128 × 128 的转移矩阵。它将最近两周潜状态的差值变换为下一周位移,再加到当前状态上:
训练用最初两个真实状态初始化,之后递归输入自己的预测。损失分别约束预测潜状态与真实潜状态的距离(rollout loss)、相邻状态位移的方向及幅度(path loss),并用随机投影高斯正则(Sketched Isotropic Gaussian Regularization,SIGReg)防止表示坍塌。预训练不重建输入;完成后冻结编码器和预测器,另训线性解码器恢复生理单位,其均方误差仅计算有观测的特征。原文未给出总参数量及行为门控的完整逐层实现。方法 §4.2.3–4.2.5
CHA 与教练分工
CHA 在实际年龄基础上,将静息心率、步数、睡眠时长和 AZM 的文献风险比换算为年龄偏移,并校正四项之间的相关性。HRV、深睡时长等预测字段不直接进入这四项核心公式;心肺适能、睡眠规律性和胰岛素抵抗另有可选组件。CHA 既计算当前健康年龄,也用于轨迹生成后的评分;它不是 SensorWM 的年龄预测头,也不进入预训练损失。方法 §4.1
方案生成先构造步数、睡眠和心肺运动的候选目标组合,在同一初始状态下分别模拟未来 12 周,再依据预测 CHA 改善和执行成本排序。维持原习惯的预测终点记为 CHA_sq,候选方案 c 的预测终点记为 CHA_c,评分为:
分子比较两个方案在同一未来时点的差异,而非当前 CHA 与未来 CHA 的差异。执行成本按各行为目标 c_k 相对个人基线 b_k 的偏离计算,并以个人历史标准差 σ_k 标准化:
因此,预测 CHA 降得最多的方案未必得分最高;改变幅度较小的方案可能获得更好的收益与成本权衡。同样增加 2,000 步,对历史步数波动较大的人产生的成本较低。标准差设有下限:500 步、15 分钟睡眠和 10 分钟心肺运动;这些数值不是候选网格的步长。该成本描述历史行为偏离程度,不等于经过实测的依从概率。方法 §4.3.2
作者仅保留预测 CHA 改善超过 0.1 年的候选,并整理成睡眠、活动和组合三类路径,最多向语言模型提供三个选项。语言模型结合这些选项、个人历史与安全约束组织 12 周计划。模型负责条件预测,优化器负责候选排序,语言模型负责计划表达;这里的优选结果限定于候选空间与模型评分,真实行为干预效果仍需前瞻验证。方法 §4.3.2–4.3.3、讨论 §3
结果与评注
独立 WEAR-ME 模型评估子集含 1,654 人。预测时持续提供参与者实际记录的未来行为,但不提供初始化后的真实生理状态;作者报告静息心率 R² 为 0.877,末次观测延续(LOCF)为 0.705、TimesFM 为 0.686。这检验的是给定行为的条件预测。训练数据来自观察记录,替换行为得到的轨迹尚未识别为因果干预效果。结果 §2.4、方法 §4.2.5–4.2.7
教练研究使用 49 个案例,由 5 名生活方式教练完成 245 次配对评分;完整系统在 71.4% 的评分中获整体偏好,反映离线计划质量评价,尚无用户真实依从性或健康结局试验。步数和睡眠本身直接进入 CHA,部分预测得分改善不需要世界模型。论文未报告保留相同 CHA、候选空间、执行成本及语言模型、仅移除 SensorWM 的教练消融,因此其预测能力与完整教练系统的偏好收益应分别判断。结果 §2.6、讨论 §3、附录 A.2–A.3
从方法定位看,行为条件下的状态转移、多步递归与方案比较,为“世界模型”命名提供了技术依据;其可直接检验的能力是周级条件轨迹预测。对健康教练更有针对性的补充对照,是保持相同 CHA、候选集合、执行成本和语言模型,将 SensorWM 分别替换为“其他指标保持不变”和简单条件预测器,比较方案排序与实际干预结果。这样的实验才能区分健康年龄公式、明确行为目标和动态预测各自带来的增益。
作者声明将于发表时发布 CHA、SensorWM 与统计分析代码;截至资料日期,指定官方仓库尚无该模型实现或权重入口。纵向 Fitbit 预训练记录因参与者同意与隐私限制不能公开共享;WEAR-ME 面向获批准研究者提供访问,All of Us 通过研究者工作台访问。数据与代码可用性声明
WBM
Apple / 南加州大学 · ICML 2025 · 论文 · 会议记录 · 官方介绍
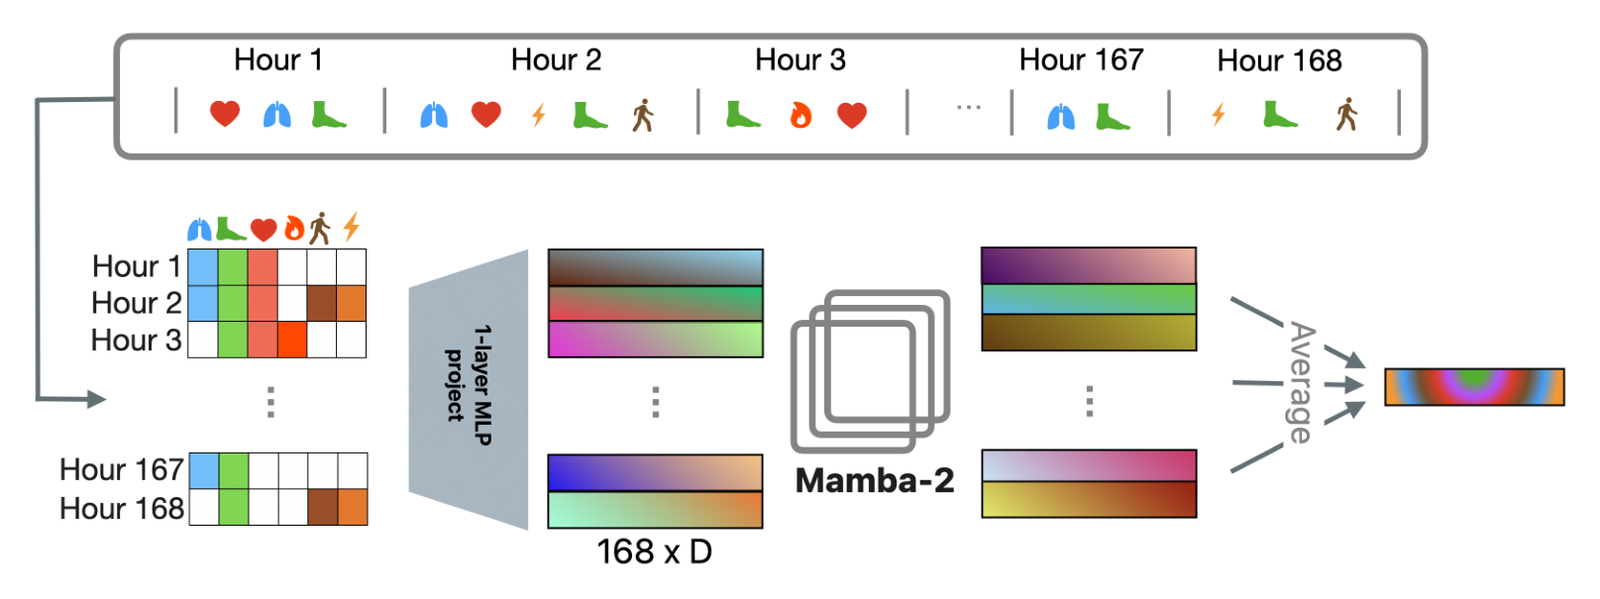
图源为 WBM 论文 Fig. 2,arXiv 2507.00191。
WBM 使用 27 个行为与健康指标,将每周小时聚合值和缺失标记组成 168 × 54 矩阵。TST 词元化后输入 Mamba-2,并以同一人的不同周作为对比学习正样本。最终骨干为 24 层,论文未给出明确的总参数量。
作者在 57 项任务上评估表征。睡眠时长回归 R² 为 0.590,拼接 PPG 表征后为 0.601。原始模型未使用睡眠指标预训练,睡眠任务标签来自 Apple Watch 的估计结果。训练与评测均按受试者划分。论文第 4-5 节及附录 A
评注
WBM 展示了小时级行为指标的周长表征学习,数据覆盖约 16.2 万人。OpenMHC 的公开 WBM 实现使用独立数据与训练过程,应与 Apple 原始权重区分。
SensorLM 与系列资源边界
SensorLM 为数值表征引入语言接口,与 LSM-2 和 SensorFM 的重构目标形成互补。其传感器编码器从 3M 扩展至 1.27B 参数,文本编码器与多模态解码器另计 12M 至 1.45B;这些数字不能混写成单一编码器规模。完整输入、零样本结果和原论文图见 SensorLM 专节。
官方仓库公开分层描述生成和 SigLIP 变体的参考训练代码,README 未列出原论文预训练检查点下载。因此“有参考代码”与“能够直接加载原作者预训练模型”应分别记录。官方代码说明 · NeurIPS 2025 记录
| 资源 | 来源与获取条件 | 复用时的区别 |
|---|---|---|
| LSM-1、LSM-2、SensorFM | 原作者论文与官方介绍;原始预训练权重的公开获取方式尚不明确 | 原论文方法与独立团队复现的权重需分别比较 |
| SensorWM | 作者计划于发表时发布代码;纵向 Fitbit 预训练数据受同意范围与隐私限制 | 论文方法可供对照;计划发布的代码不能作为现有实现或权重入口 |
| WBM | 作者明确因研究参与者知情同意限制而无法发布代码与权重 | Apple 原始模型与独立复现具有不同的训练数据和参数 |
| WavesFM | 两阶段波形与纵向表征研究;对应论文的官方代码、权重或数据获取方式尚不明确 | 与同名无线通信项目不同;原文人数及时间块长存在报告差异 |
| SensorLM | 原作者参考代码,包含描述生成与 SigLIP 训练变体 | 参考实现的训练目标需与论文具体变体对应 |
| OpenMHC 的 WBM / LSM 复现 | 由独立团队在独立数据上训练 | 可作开放评测对照,其检查点不属于 Google 或 Apple 原始模型 |
WavesFM
Google Research / MIT / 华盛顿大学 · arXiv 2026 · 论文
WavesFM 将短时波形表征与周内时间结构连接,使原始信号预训练和纵向健康表征可以在同一框架中比较。其全名为 WavesFM: Hierarchical Representation Learning for Longitudinal Wearable Sensor Waveforms,不同于同名无线通信模型。
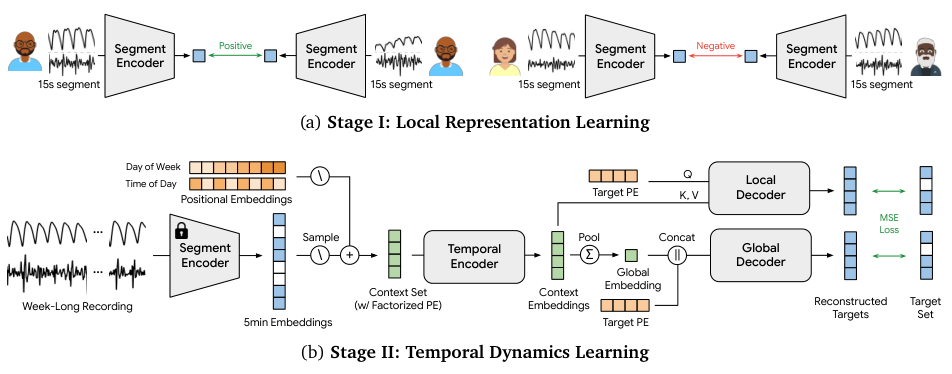
图源:WavesFM 论文 Fig. 2(arXiv:2605.09173v1),直接裁剪原论文。
| 层级 | 输入与架构 | 训练目标与输出 |
|---|---|---|
| 第一阶段 | 15 秒 PPG 与 ACC 模长,重采样至 100 Hz;EfficientNet-B7 | 同一人不同片段的对比学习,输出 256 维片段表示 |
| 中间汇聚 | 每 20 个相邻片段表示取均值 | 每 5 分钟一个向量,一周 2016 个位置;缺测以可学习词元表示 |
| 第二阶段 | 冻结第一级编码器;6 层、4 头、256 维 Transformer,加入日内时刻与星期位置编码 | 局部与全局双分支重建被遮挡的表示,学习周级表征 |
第一阶段用约 32.4 万人的 680 万小时片段,第二阶段用其中约 1 万人的 530 万小时纵向记录,共 6.12 万条周长记录。模型总参数量未报告。第二阶段学习的是嵌入序列,不是再次输入整天原始波形;五分钟内的顺序被均值汇聚,不能描述为无损保留长时原始信号。方法与附录 B/C
同团队的 AI-PPG-ACC-HTN 将短波形对比预训练用于高血压筛查,随后按日内小时跨日汇聚并训练逻辑回归。WavesFM 在片段对比学习之后增加表征序列的掩码预测;其 32.4 万人第一阶段与高血压研究的 2,109 人预训练使用不同数据池。两项研究的训练目标、规模与临床验证条件对照见该小节。
作者在 58 个个体级二分类任务上报告平均 AUROC 0.766,形态表示直接平均为 0.748,19 个手工特征加同配置时间编码器为 0.728。两类基线由作者在同源数据上构造,不是原版 LSM、SensorFM 或 Apple WBM。下游以自报健康、生活方式等标签为目标,冻结编码器并训练逻辑回归。评测把每人的全部可用周级向量平均,因此主结果不能直接解释为只观察一周的表现。第 4 节及 Table 8
评注
这一两级预训练设计连接了局部形态与长期节律,但尚未验证跨设备、缺失整路传感器或急性事件任务。原文将 LSM、LSM-2、WBM 均归入广义 Behavior-Centric;更精确的共同名称是派生指标驱动的纵向生理与行为建模,不能仅凭分钟级或小时级粒度区分生理与行为。
原文存在两项报告差异:正文下游总人数为 11,736,附录 B 划分人数却合计 15,700;§3.2 的块长 1、2、4 与其文字标注的 5、20、60 分钟不符。二者都会影响实验复现。截至 2026-11-04,数据未公开,对应这篇可穿戴论文的官方代码与权重获取方式尚不明确。
时间尺度与历史汇聚
输入窗口、最终预测使用的历史总量和结果更新周期需要分别记录。日级编码器可以利用多天历史,周级编码器也可以在滑动窗口中每天更新;后者属于部署设计选项,并非本文确认的线上实现。
| 工作 | 窗口内部怎样建模 | 跨窗口或未来时点怎样处理 |
|---|---|---|
| SensorFM | 一天的分钟级派生特征,学习日内时序与跨通道关系 | 全部可用天数中的有效表示取均值和标准差 |
| SensorWM | 每周一个状态向量,12 周窗口训练递归动力学 | 两周观测初始化,按外部行为序列逐周预测;教练应用比较未来 12 周方案 |
| WavesFM | 短段波形先编码,再对一周的五分钟表示学习有序关系 | 全部可用周级向量取平均 |
SensorFM 与 WavesFM 的差别支持比较“日内编码加跨日统计汇聚”和“周内有序编码加跨周汇聚”,不能归纳为两者只用了不同天数的数据。SensorFM 的日期编码提供日历背景,但不等同于在一次注意力计算中联合观察多天的实际轨迹。SensorFM 方法 M.3 · WavesFM 第 3-4 节
WavesFM 将工作日与周末差异作为一周窗口的动机,但未报告控制输入、数据和架构后的 1 天与 7 天窗口消融。附录 E 比较的 252、504、1008 个上下文位置,是同一周内的可见比例,不是不同历史跨度。周期性只能说明值得考虑跨日信息,不能证明 7 天是通用最优窗口。WavesFM 第 2.2 节及附录 E
季节变化也不必通过每次输入一年原始信号来处理。训练数据覆盖不同季节、日期与环境条件、个人长期基线、单次输入窗口分别解决不同问题。SensorFM 已包含年内日期编码,LSM-2 则将季节与年尺度列为后续研究。日期背景不能替代个体的真实长期变化。SensorFM 方法 M.3.1 · LSM-2 附录 A.6
工程评注
可保留近期细粒度表示、跨日时序表示和缓慢更新的个人基线,由目标任务选择所需历史。在同一批用户、同一预测时点上比较 1、3、7、14、28 天,并用相同长历史的统计汇聚作对照,才能区分历史变多与时序结构带来的收益。除预测指标外,应比较状态变化响应、缺失鲁棒性、跨季节泛化和计算成本;这些是评测建议,不是上述论文已经完成的结论。
产品关联与证据边界
Google 在 2026 年 8 月的产品介绍中明确将血压趋势功能关联到 WavesFM,并将胰岛素抵抗趋势功能的基础模型链接指向 SensorFM 官方介绍。两条路线因而具有不同的产品落点,不能把整个 Google Health 归结为一个模型。Health Guardian 产品介绍 · SensorFM 官方介绍
该产品页血压段落的验证链接指向 AI-PPG-ACC-HTN 预印本,该研究随后发表于 Nature。作者介绍同样说明其研究帮助形成血压趋势功能,构成两项工作的直接产品关联。高血压论文报告的是跨日均值汇聚系统,WavesFM 则包含周级时序编码;公开材料没有说明二者使用同一检查点或完整模型。Nature 研究介绍
这些资料说明了研究与功能的关联,但未给出生产检查点、推理窗口、聚合实现或手表、手机与云端的计算分工。产品页面将血压趋势定位为健康信息功能;论文中的筛查准确性对应其研究队列与协议,不等同于产品的实时临床测量能力。
选型与评测建议
| 研究条件 | 优先对照 | 需要保留的实验信息 |
|---|---|---|
| 分钟级多传感器指标齐全 | LSM-1、LSM-2、SensorFM 路线 | 特征定义、缺失率、窗口长度、受试者划分 |
| 观测严重碎片化 | LSM-2 的 AIM | 真实与人工缺失来源、整模态缺失、连续脱表时段 |
| 小时级长期行为指标 | WBM 路线 | 聚合方式、周级覆盖率、个体级正样本、标签时间窗 |
| 给定行为方案预测未来生理变化 | SensorWM 路线 | 未来行为是否已知、递归误差、观察关联与干预效果、保留 CHA 的无世界模型对照 |
| 同时保留局部波形与跨日关系 | WavesFM 路线 | 波形质量、两阶段划分、五分钟压缩、跨周汇聚与原文报告差异 |
| 希望获得可运行的开放对照 | OpenMHC 复现、SensorLM、NormWear | 原作者或复现身份、训练队列、许可和实际权重入口 |
以上选择是基于论文输入与方法作出的工程判断。模型规模之外,还应报告工程特征加线性模型或树模型的对照、冻结与微调结果,以及跨设备和跨人群表现。训练时长应同时提供人数、窗口数、采样粒度和有效观测占比,便于识别同一统计量的不同计数方式。